Tracer des agents IA : les spans d’une exécution et ses tokens
Un rapport de coûts affiche 17 200 tokens d’entrée pour un appel qui en a lu 9 200 (chiffres fictifs). D’où viennent les 8 000 de trop ?
EN 30 SECONDES
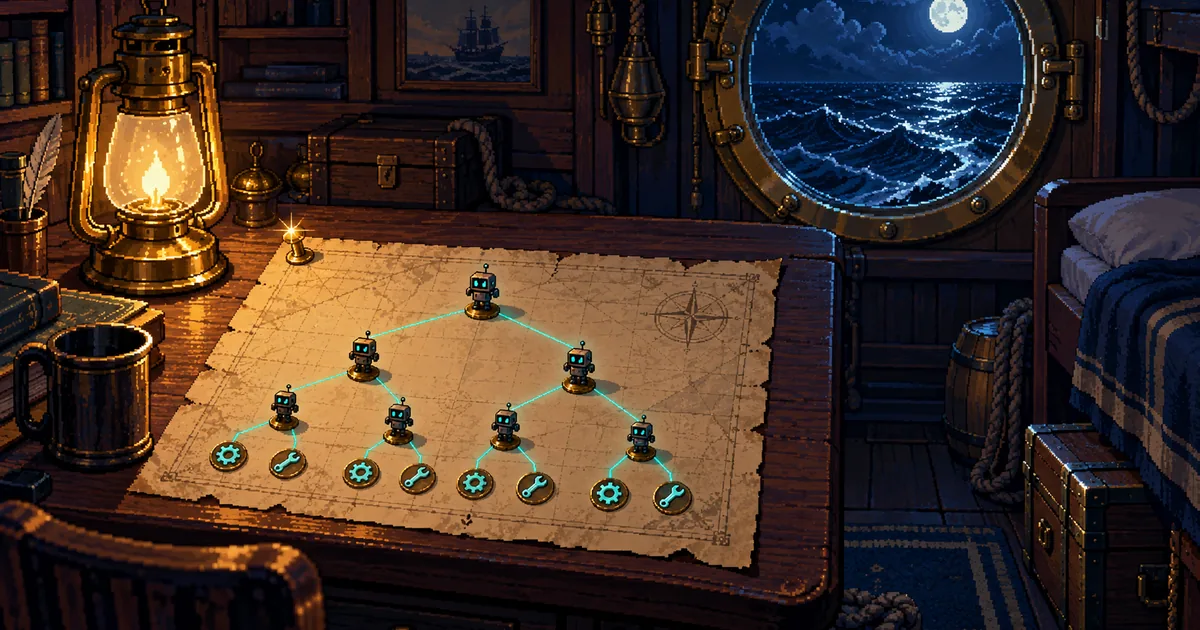
Une trace multi-agents est l’arbre des spans d’une exécution. Dans une exécution coordonnée : un span de workflow, un span par invocation d’agent, et les appels de modèle et d’outils sous chacune. Sur chaque appel de modèle, gen_ai.usage.input_tokens devrait déjà inclure les tokens en cache : y ajouter les champs de cache les compte deux fois.
À RETENIR · 3
- Une exécution multi-agents coordonnée peut former une seule trace : un span invoke_workflow, un span invoke_agent par invocation d’agent, et des spans d’inférence et execute_tool sous chacune.
- gen_ai.agent.version n’est plus sur le span d’agent local (#322). Si un auditeur doit savoir quelle version a agi, portez-la vous-même.
- gen_ai.usage.input_tokens devrait déjà inclure les tokens en cache. Tarifez la part en cache à son propre prix, sans jamais l’ajouter par-dessus.
Sur cette page
Un span par invocation d’agent, ses appels en dessous
EN BREF Dans une exécution coordonnée, un span de workflow contient un span par invocation d’agent, et les appels de modèle et d’outils de chacune s’y imbriquent.
LES MOTS À CONNAÎTRE
- Span
- Une étape de travail chronométrée, comme un appel de modèle ou d’outil, avec un nom et des paires clé-valeur appelées attributs.
- Trace
- L’ensemble des spans d’une exécution, reliés de parent à enfant, pour voir quelle étape en a lancé une autre.
- Token
- Un petit morceau de texte, souvent un fragment de mot. Les modèles lisent et écrivent des tokens, souvent facturés à l’unité.
- Tokens en cache
- Une entrée que le fournisseur a déjà traitée lors d’un appel précédent et réutilise, souvent facturée à un autre prix.
La page des spans d’agents nomme chaque niveau, sans version publiée. Une exécution coordonnée peut tenir dans un Span Une étape de travail chronométrée, comme un appel de modèle ou d’outil, avec un nom et des paires clé-valeur appelées attributs. Voir le glossaire invoke_workflow. Chaque appel d’agent y reçoit invoke_agent, suivi de son nom.

EN CLAIR
Le type d’un span dit si le travail reste dans votre processus ou part vers un autre service. Les conventions recommandent INTERNAL pour un agent local, et CLIENT pour un agent distant ou hébergé.
UN AGENT, UNE EXÉCUTION
Étape 1. L’agent démarre. Le span de workflow ouvre un span invoke_agent pour cet agent.
- L’agent démarre Le span de workflow ouvre un span invoke_agent pour cet agent.
- Il appelle le modèle L’appel devient un span d’inférence nommé d’après l’opération et le modèle. Tokens et identifiant de réponse y figurent.
- Le modèle demande un outil Cette réponse appartient au span d’inférence ; aucun nouveau span ne s’ouvre encore.
- L’outil s’exécute L’agent l’exécute dans un span execute_tool, avec le nom de l’outil et l’identifiant d’appel.
- Un second appel de modèle Le résultat repart vers le modèle dans un second span d’inférence, lui aussi enfant du span d’agent.
- L’agent se termine Son span se ferme et l’agent suivant ouvre le sien, dans la même trace.

ATTENTION
gen_ai.agent.id devrait porter l’identifiant fixe qu’un fournisseur donne à un agent hébergé. Pas celui d’une instance en mémoire : la spec le déconseille (« NOT RECOMMENDED »). L’attribut a aussi quitté le span d’agent local.

ADAM explique : gen_ai.agent.version a aussi quitté ce span local (#322). Un auditeur demandera quelle version de quel agent a agi : portez-la vous-même.
Chaque agent a aussi ses métriques : gen_ai.invoke_agent.duration, .inference_calls et .tool_calls. Ce sont des histogrammes : elles montrent la répartition des valeurs.
Les comptes inference_calls et tool_calls sont l’alerte précoce la moins chère que je connaisse pour un agent devenu bavard après un changement de prompt.
Un exemple concret : un appel de modèle, bien compté
EN BREF Sur un appel de modèle, gen_ai.usage.input_tokens devrait déjà inclure les tokens en cache : y ajouter les champs de cache les compte deux fois.
La page Anthropic le précise : chez Anthropic, input_tokens exclut les Tokens en cache Une entrée que le fournisseur a déjà traitée lors d’un appel précédent et réutilise, souvent facturée à un autre prix. Voir le glossaire. La valeur des conventions est donc input_tokens + cache_read_input_tokens + cache_write_input_tokens. Les valeurs plus bas sont fictives.
UN EXEMPLE CONCRET
Chiffres illustratifs
VALIDÉUne étape de rapprochement, comptée selon les conventions
ENTRÉE
- Entrée hors cache
- 1 200 tokens
- Lus en cache
- 8 000 tokens
- Écrits en cache
- 0
CE QUI SE PASSE
- L’instrumentation additionne les trois : 1 200 + 8 000 + 0.
- Elle inscrit 9 200 dans gen_ai.usage.input_tokens, et 8 000 dans gen_ai.usage.cache_read.input_tokens.
- Votre rapport tarife les 8 000 au prix de lecture en cache, les écritures éventuelles au prix d’écriture, et les 1 200 au plein tarif.
SORTIE
- Tokens d’entrée sur le span
- 9,200
- Facturé
- chaque part à son prix
COMPTÉ DEUX FOISMême span, additionné naïvement
ENTRÉE
- gen_ai.usage.input_tokens
- 9,200
- gen_ai.usage.cache_read.input_tokens
- 8,000
CE QUI SE PASSE
- Un rapport ajoute le champ de cache à input_tokens, comme s’ils étaient séparés.
- 9 200 + 8 000 donnent 17 200, près du double de l’entrée réelle.
- Au plein tarif d’entrée, les 8 000 tokens en cache coûtent bien plus qu’ils ne devraient.
SORTIE
- Tokens d’entrée dans le rapport
- 17,200
- Résultat
- coût surestimé

OBJET OBTENU
Compter l’entrée une fois
Noms, types et clés suivent les conventions au commit 4f85037. com.acme.* remplace votre domaine inversé, comme le conseille le guide de nommage. Les valeurs sont inventées, le tout aplati.
{
  "spans": [
    {
      "name": "invoke_agent recon-agent",
      "kind": "INTERNAL",
      "attributes": {
        "gen_ai.agent.name": "recon-agent",
        "com.acme.agent.version": "4.2.0",
        "com.acme.audit.record_id": "01K4R7QW3M8ZC2VJ9F0X6TBNPD"
      }
    },
    {
      "name": "chat claude-haiku-4-5-20251001",
      "kind": "CLIENT",
      "attributes": {
        "gen_ai.provider.name": "anthropic",
        "gen_ai.response.model": "claude-haiku-4-5-20251001",
        "gen_ai.usage.input_tokens": 9200,
        "gen_ai.usage.cache_read.input_tokens": 8000,
        "gen_ai.usage.output_tokens": 310
      }
    }
  ]
}
Pas de gen_ai.conversation.id ici. S’il n’y en a pas, la spec dit de ne pas en inventer un (« SHOULD NOT ») à partir d’un identifiant généré ou de trace.
Sources, consultées le 7 octobre 2026 : spans d’agents, spans, inférence client, Anthropic.
FAQ
Mettez l’exécution dans un span invoke_workflow ; chaque appel d’agent a son span invoke_agent. Dessous viennent les appels de modèle (spans d’inférence) et d’outils (spans execute_tool). Le contexte de trace fait le lien.
NIVEAU TERMINÉ
Ce que vous savez maintenant
- Comment les spans de workflow, d’agent, de modèle et d’outil d’une exécution peuvent s’emboîter dans une seule trace.
- Pourquoi ajouter les champs de cache à gen_ai.usage.input_tokens peut compter deux fois les tokens en cache.
Vérifiez par vous-même
Touchez ou cliquez une question pour voir la réponse.
Un span fictif indique input_tokens 5 000, cache_read.input_tokens 4 000 et aucune écriture en cache. Combien de tokens d’entrée n’étaient pas en cache ?
1 000. Selon les conventions, input_tokens inclut déjà les 4 000 tokens en cache : on les soustrait, on ne les ajoute jamais.
Ingénieur web3 x IA, ancien CTO d’Integra. Auteur nommé (1 sur 5) d’ERC-3643, premier auteur d’ERC-6960, co-auteur d’ERC-7410 et co-auteur d’ERC-8203, encore à l’état de brouillon.
Un projet à livrer ou un poste à pourvoir ?
Parlons de votre besoinSuivre les notes techniques
Recevez les nouveaux articles sur l’IA en production et les smart contracts par email.